中国のオープンソース言語モデルがClaude、GPT-5.5、Geminiをコーディングチャレンジで上回る
Hacker Newsで紹介された元記事をもとに、AIで翻訳・要約しています。 編集方針
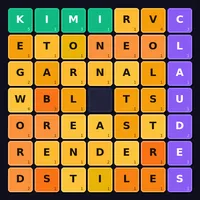
AIコーディングチャレンジの12回目では、中国のMoonshot AIが開発したオープンソースモデル「Kimi K2.6」が、MiMo V2-Proに次いで1位となりました。
GPT-5.5は3位、Claude Opus 4.7は5位に甘んじました。
このチャレンジは「ワード・ジェム・パズル」という、文字タイルをスライドさせて単語を形成するもので、Kimi K2.6は積極的にタイルをスライドさせる戦略で勝利しました。
今回の結果は、オープンソースモデルと既存の主要モデルとの差が縮まっていることを示唆しています。
中国のスタートアップMoonshot AIが開発したオープンウェイトモデル「Kimi K2.6」が、大規模言語モデル(LLM)のプログラミング競技会で、ClaudeやGPT-5.5、Geminiといった西側主要モデルを破って優勝したことが明らかになりました。この結果は、AIの性能評価における新たな潮流を示唆しており、注目を集めています。
AIコーディング競技会の概要
今回の競技会は、LLMにスライディングタイルパズル「Word Gem Puzzle」をリアルタイムで解かせる形式で行われました。このパズルは、グリッド状の盤面に配置された文字タイルを動かし、水平または垂直に英単語を形成させるものです。
単語のスコアリングは、7文字以上の長い単語を優遇し、短い単語にはペナルティが課される仕組みです。各モデルは5ラウンドを戦い、制限時間内にどれだけ効率的に単語を生成し、スコアを稼ぎ出すかが試されました。
中国モデルの圧倒的勝利と戦略
優勝したKimi K2.6は、文字を積極的にスライドさせる「貪欲(Greedy)」な戦略を採用していました。これは、可能なすべての移動の中で、最も多くのプラス評価の単語を解き放つ移動を選択し続ける手法です。
この戦略は、盤面が大きく文字がランダムに配置される30×30のグリッドで真価を発揮しました。文字がバラバラになった状況で、Kimiは累積スコア77を叩き出し、他の追随を許しませんでした。一方、他の主要モデルは、このパズル特有の「スライド」というアクションをうまく実行できなかったことが敗因と見られています。
西側主要モデルの課題と限界
GPT-5.5やClaude Opus 4.7といった西側の高性能モデルも上位に入りましたが、それぞれ戦略的な課題を抱えていました。GPT-5.5はバランスの取れた動きを見せましたが、Claudeは盤面のランダム性が高まる30×30のボードで性能が低下しました。
また、一部のモデルは、短い単語にペナルティがあるというルールを無視し、無駄な単語を大量に主張してしまい、大幅なマイナススコアを記録するという、致命的な戦略ミスを犯した事例も報告されています。
結論:オープンウェイトの台頭
今回の結果は、単に「中国モデルが勝った」という単純な話ではなく、特定のタスクにおけるモデルの設計思想や戦略の有効性が重要であることを示しています。オープンウェイトで公開されているKimi K2.6がトップに立ったことは、AI開発における多様なアプローチの価値を再認識させる出来事だと言えます。